 服务热线:010-62410836

-
 京存全闪存储,顺序读 19.2GiB/s、顺序写 10.8GiB/s,稳定低长尾延迟,高吞吐不掉速。适配 AI 数据集加载、工业仿真、4K/8K 媒资、大规模备份,为智算集群提供稳定高性能存力底座。
 2026-10-28 16:51:40
 188
-
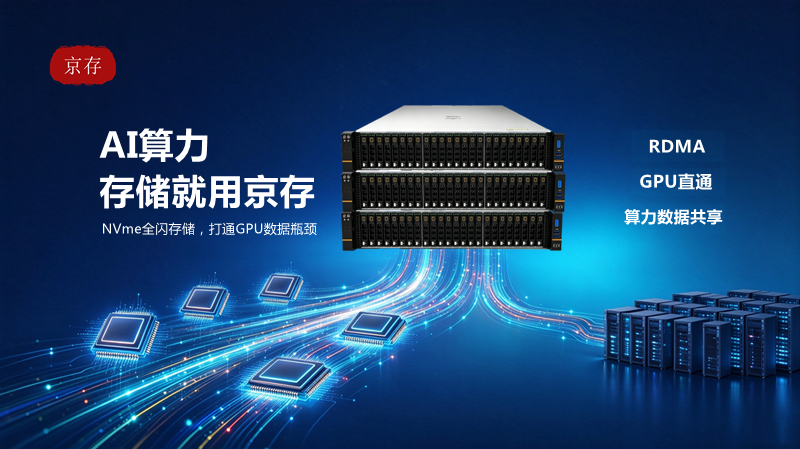 国内具身智能赛道上游核心企业采用京存高性能混闪存储,项目部署 1.5PB 混闪存储,稳定读带宽 20GB/s、写带宽 10GB/s,为 GPU 集群搭建统一数据底座,支撑机器人仿真、物理 AI 模型训练,解决仿真与模型训练混合负载下的存储瓶颈,释放 GPU 算力,助力国产具身··· 2026-10-22 14:39:02 188
-
 京存集中式单控存储,单组系统容量高达6PB存储空间,单一机头具有高达16GiB/s读写带宽,具备SSD加速功能,SAN与NAS统一存储无需额外配置NAS网关,适用于算力中心、政府、军工、金融、教育等行业,应用于智算、大模型等场景。 2026-10-20 16:04:55 188
-
 随着智能制造落地,AOI 自动光学检测、AI 视觉质检已经成为光伏、半导体、3C 电子、汽车零部件这些行业做质量管控的常用手段。高速线扫和面阵工业相机不停抓拍高清产品图片,单条产线一天下来就能产生 TB 级图像数据。京存销售人员在对接工厂客户人员时,他们··· 2026-09-24 15:39:35 188
-
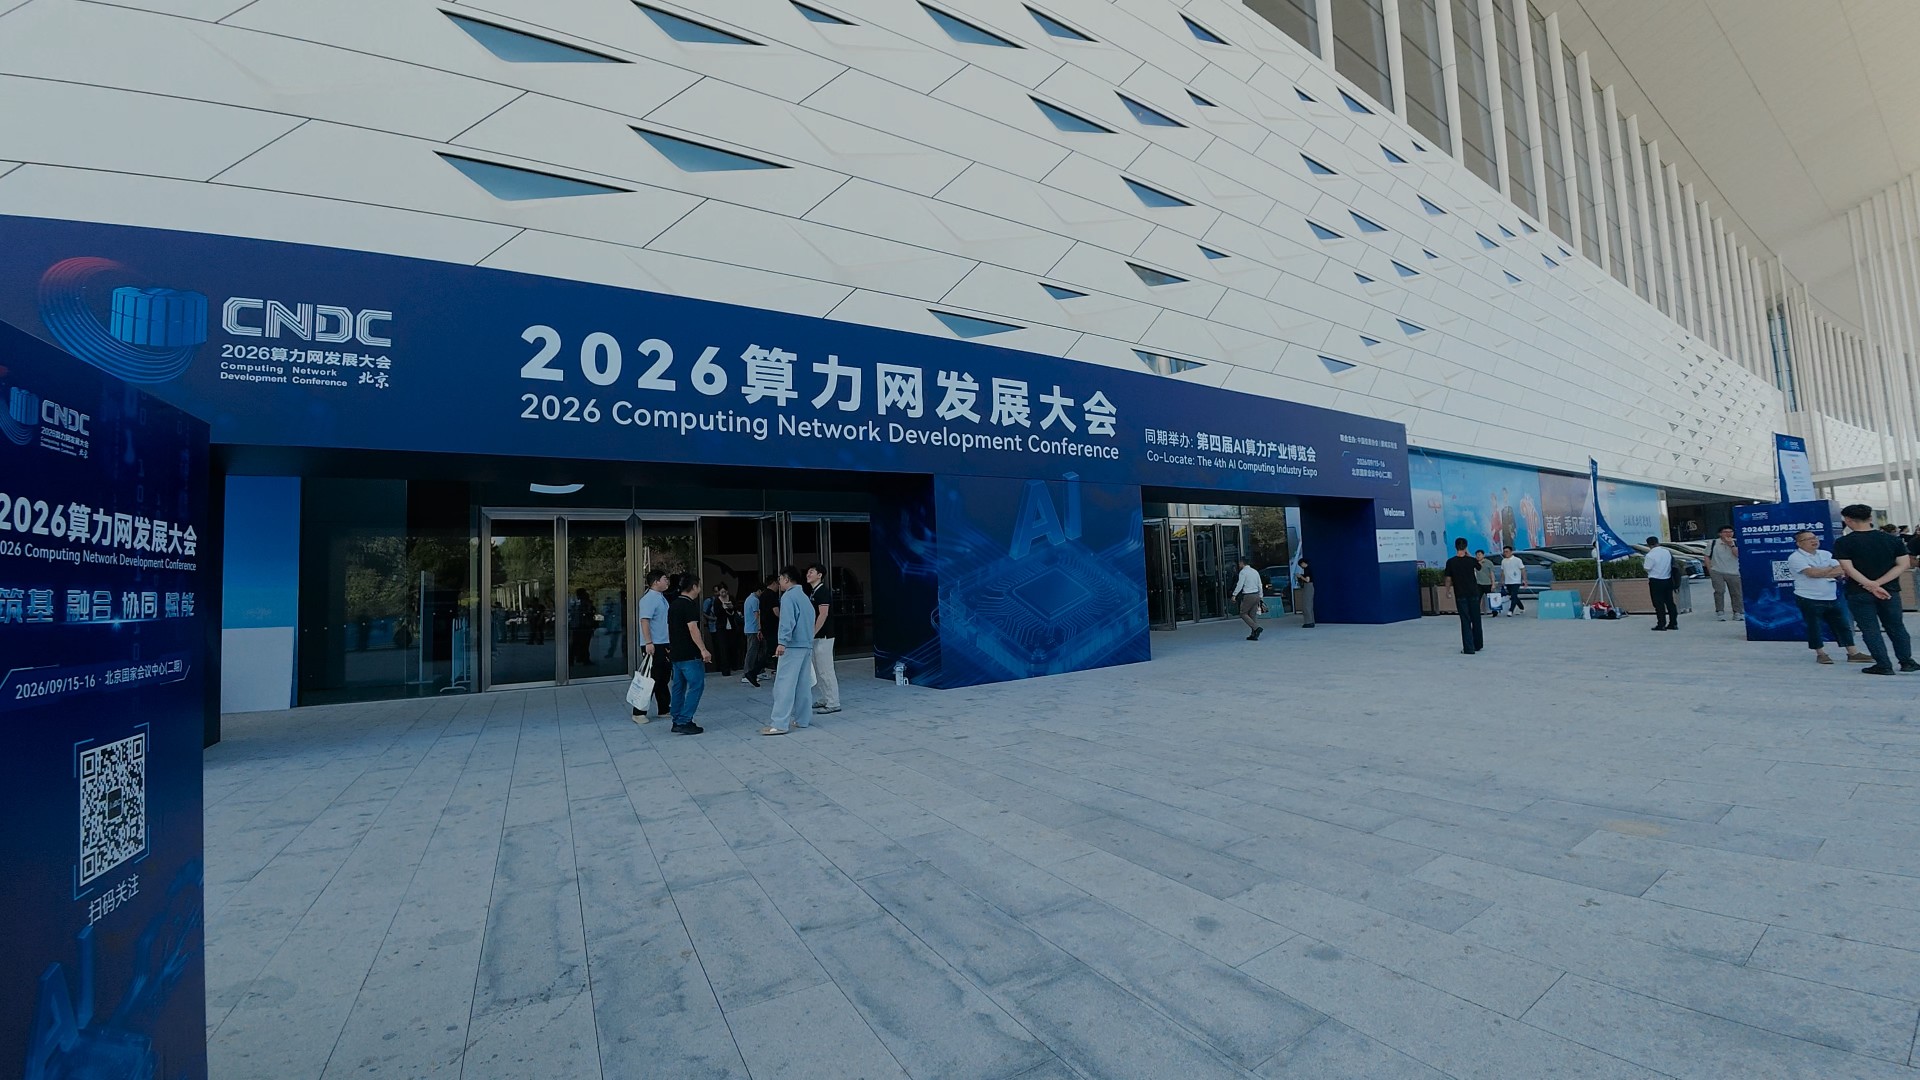 2026 算力发展大会圆满落幕,国产存储厂商京存存储完成本次参展。展会期间,京存重点展出面向 AI 训推、HPC 超算场景的自研 NVMe 全闪存储、分布式并行文件存储方案,吸引众多算力领域客户与生态伙伴参观交流。京存存储聚焦存储墙难题,以低时延、高并发、国产··· 2026-09-18 10:35:53 188
-
 京存国产自研存储,适配 AI 大模型训推、智算中心、超算 HPC,支持 PB 级弹性扩容,信创适配,提供分布式全闪、NVMe 全闪存储解决方案。京存 AI 大模型全闪存储,端到端 NVMe 架构,RDMA 高速协议适配 H100/A100,低延迟释放 GPU 算力,保障 7×24 小时大模型··· 2026-08-31 09:57:02 188
-
 随着大模型训练、推理、高性能仿真业务快速落地,海量小文件高并发、超大带宽吞吐、极低访问时延,成为 AI 业务对底层存储的硬性要求。传统存储受架构约束,扩容性能衰减、存在单点瓶颈、时延居高不下,严重拖累算力整体输出效率。京存高性能全闪存储 ,原生底··· 2026-08-13 11:48:38 188
-
 双控 NVMe 全闪共享存储凭借双控不间断架构、多协议共享、GPU 直通加速、大小文件混合负载优化四大特性,既能满足数据标注、算法人员便捷访问数据集的需求,又可为 GPU 训练集群提供低时延高速读写能力,是当前 AI 赛道高性能非结构化存储的优选方案。 2026-08-06 16:02:55 188
-
 京存双控 NVMe 全闪存储,搭载双活控制器与端到端 NVMe 全闪架构,顺序带宽可达 20-70GB/s,支持海光飞腾国产平台,适用于数据库、虚拟化、AI 训练、高性能计算等场景,北京智慧仓存储技术有限公司出品。 2026-07-22 13:57:38 188
-
 京存源头自研信创存储,整机 CPU 主板内存国产设计,搭载海光 HG、飞腾 FT 处理器,自有专利 RAID 技术,NVMe 全闪、NAS 归档、灾备一体机全覆盖,千万级 IOPS 高带宽,适配政务广电医疗科研国产化项目。 2026-07-15 11:26:08 188