 服务热线:010-62410836

具身智能是人工智能前沿方向,人形机器人、移动机器人研发过程中,大规模并行仿真、传感器多模态数据接入、物理 AI 模型训练会持续产生海量仿真帧、点云、图像、运动轨迹数据。
这类业务属于典型混合负载,仿真环节高并发写入、模型训练持续大带宽读取,冷热数据长期并存,存储带宽、访问时延、扩展能力以及整体拥有成本,直接影响 GPU 集群算力利用率,
是机器人研发迭代中的关键基础设施瓶颈。
近日,国内具身智能赛道上游核心企业正式部署京存高性能混闪存储,为 GPU 智算集群打造统一数据底座,承载机器人仿真推演、数据预处理以及物理 AI 模型训练等核心研发业务。
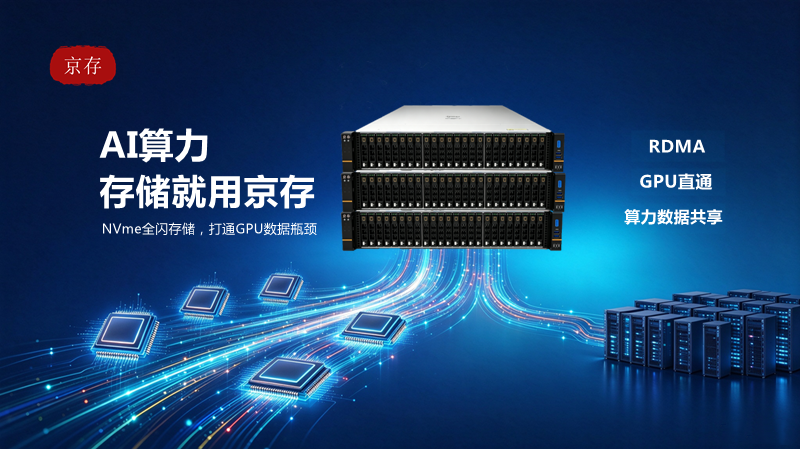
该项目配置总容量 1.5PB 混闪存储,稳定实现读带宽 20GB/s、写带宽 10GB/s。方案采用 SSD+HDD 智能分层架构,热点训练样本、实时仿真数据自动调度至闪存介质,保障高吞吐、
低时延访问;历史仿真日志、离线归档数据集自动下沉至硬盘层,兼顾 PB 级大容量存储需求,有效降低整体 TCO,适配具身智能场景冷热数据动态流转的业务特征。
整套存储系统提供全局统一命名空间,支持大量 GPU 节点并发访问、多研发任务并行调度,打通数据清洗、仿真运算、模型训练、效果回放全业务链路,有效破除 “算力等数据” 的存储墙问题,
持续提升 GPU 资源利用率,加快机器人算法验证、仿真迭代、真机适配节奏。
针对 AI 智算 7×24 小时不间断运行的严苛要求,京存高性能混闪存储搭载高可用架构,支持故障自动感知、业务无感知切换,性能与容量支持线性横向扩展,
能够跟随客户 GPU 集群规模增长持续扩容,满足人形机器人、移动机器人等具身智能研发长期演进需求。
项目顺利上线,依托双方技术团队紧密协同、联合调优,完成多轮负载压测、场景适配与上线验证,保障存储系统匹配具身智能复杂混合负载。
随着具身智能、机器人产业加速发展,稳定、高性能、可扩展的数据底座已经成为科创企业的核心基础设施。
京存长期聚焦 AI、HPC、工业仿真等高性能场景,持续研发国产并行存储、混闪存储、全闪存储产品,面向大模型预训练、自动驾驶仿真、机器人具身智能等场景提供存力支撑。
未来,京存将持续打磨高性能存储技术,深化存算协同方案,携手产业伙伴共同推动国内人工智能与机器人产业创新落地。