 服务热线:010-62410836

算力集群存储方案

适用场景:大模型预训练 / 微调算力平台、AIGC 多模态生成、计算机视觉数据集训练、科研 HPC 仿真计算。
随着大模型、机器视觉等业务落地,GPU 算力集群常因存储 IO 瓶颈导致算力资源闲置。
传统本地盘、普通 NAS 无法满足多计算节点并发共享访问、亿级小文件读写、业务不中断扩容等核心诉求。
京存双控全闪存储方案,一套存储同时支撑标注、训练、微调、推理、数据归档全业务链路,消除多套存储的数据孤岛,
简化数据流转与运维管理。帮助算力中心提升 GPU 利用率,缩短模型迭代周期,在保障高可靠、高并发能力的前提下,有效控制项目总体拥有成本。
针对以上情况,北京智慧仓推出了一套高性能、高可靠和优质服务的双控全闪存储解决方案
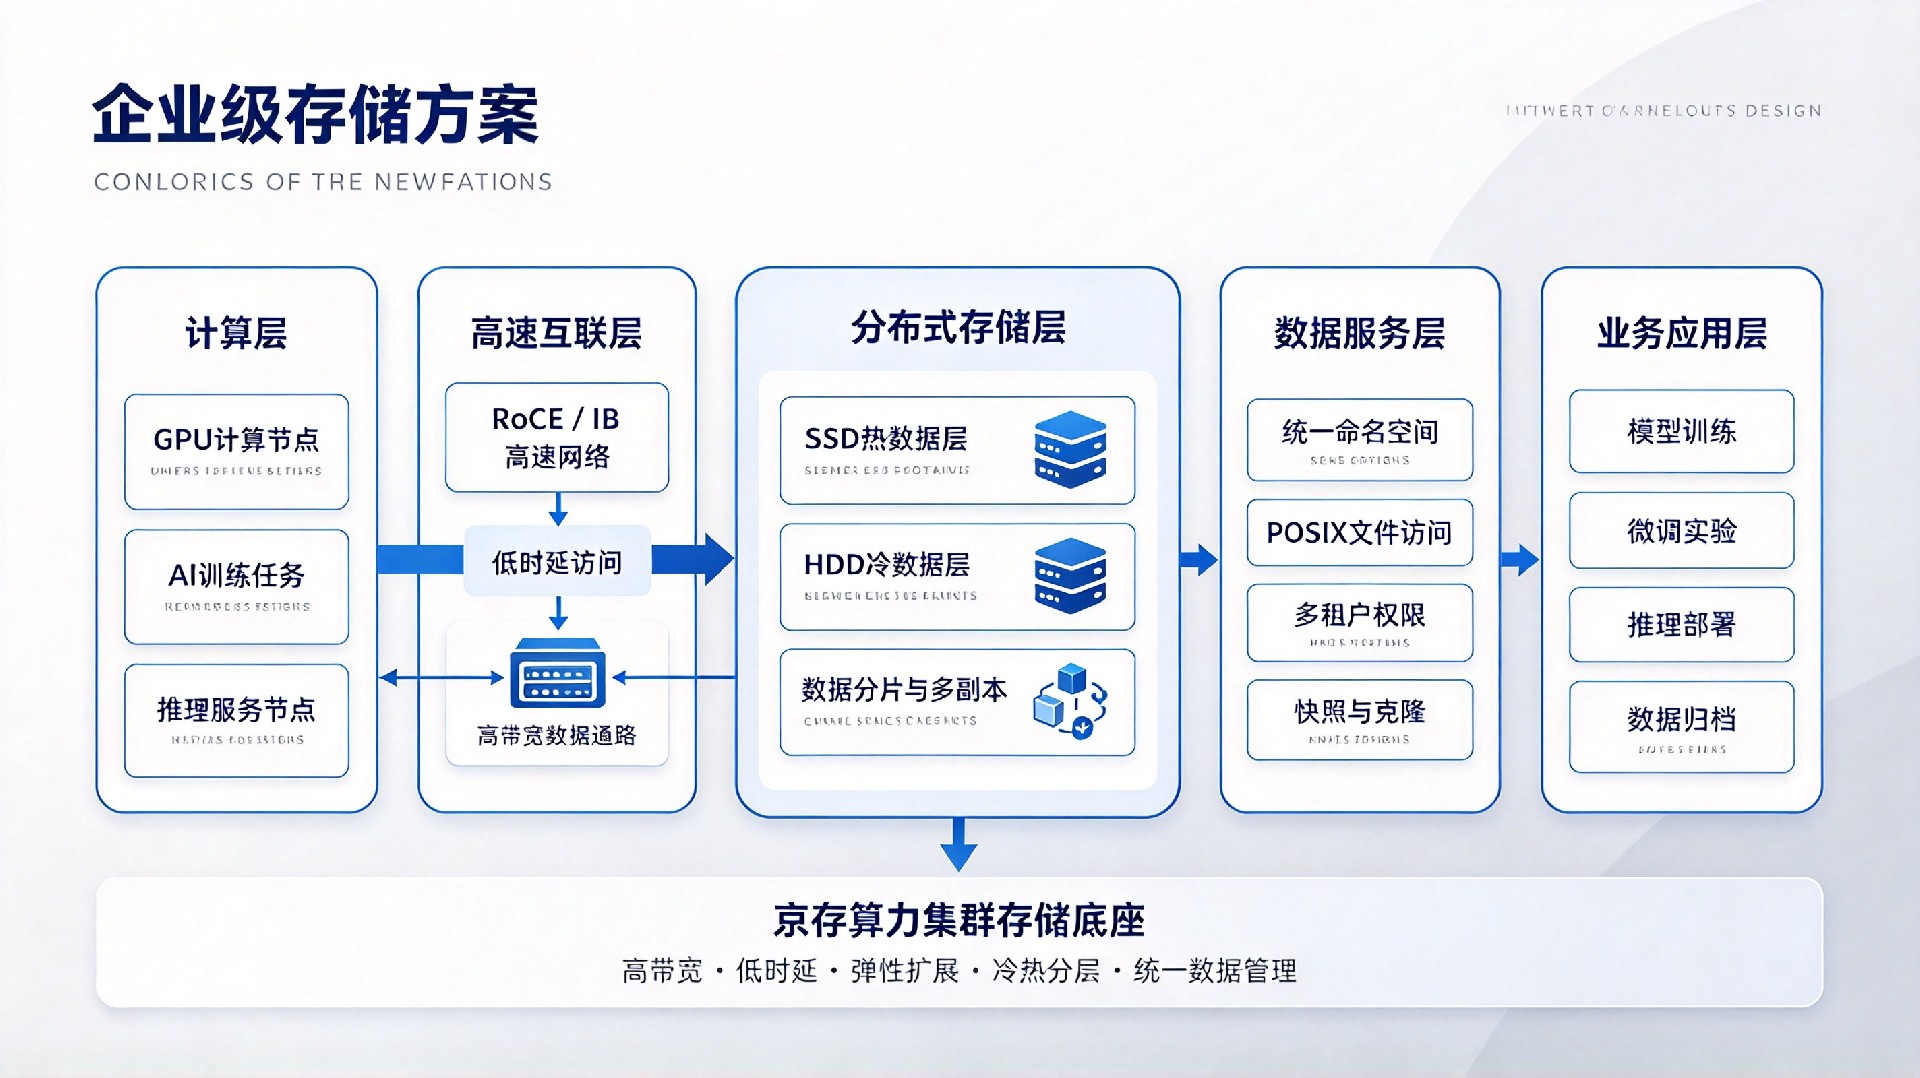
存算力集群存储采用双控全闪NVMe架构,打造算力协同的统一数据底座。
具体优势如下:
● 采用双控 Active Active 高可用架构,实现 7×24 小时不间断 AI 训练,业务零中断;
● 端到端 NVMe 全闪架构,可实现 200 万 IOPS、80GB/s 带宽,低至 0.3ms 微秒延迟;
● 原生 RDMA/IB 高速协议,深度适配 H100/A100 集群,消除 GPU 算力空等;
● 块 + 文件多协议融合,一套存储覆盖数据集、模型 Checkpoint、仿真计算业务,为大模型训练推理提供高速可靠的底层存储支撑。